 RankASO
App Store 搜索原理:哪些被索引,哪些没有
其他语言: English · 日本語 · Português · Español · Deutsch
App Store 搜索索引你商店页面的三个字段:名称、副标题和关键词字段,把一次搜索与其中词语的任意组合进行匹配,再按商店判断的相关性和表现为匹配到的应用排序,每个国家的商店各自独立。描述、截图和更新说明都不参与搜索索引。确切地知道哪些被读取,就知道每个词必须放在哪里,也知道排名追踪器实际在衡量什么。
哪些被索引
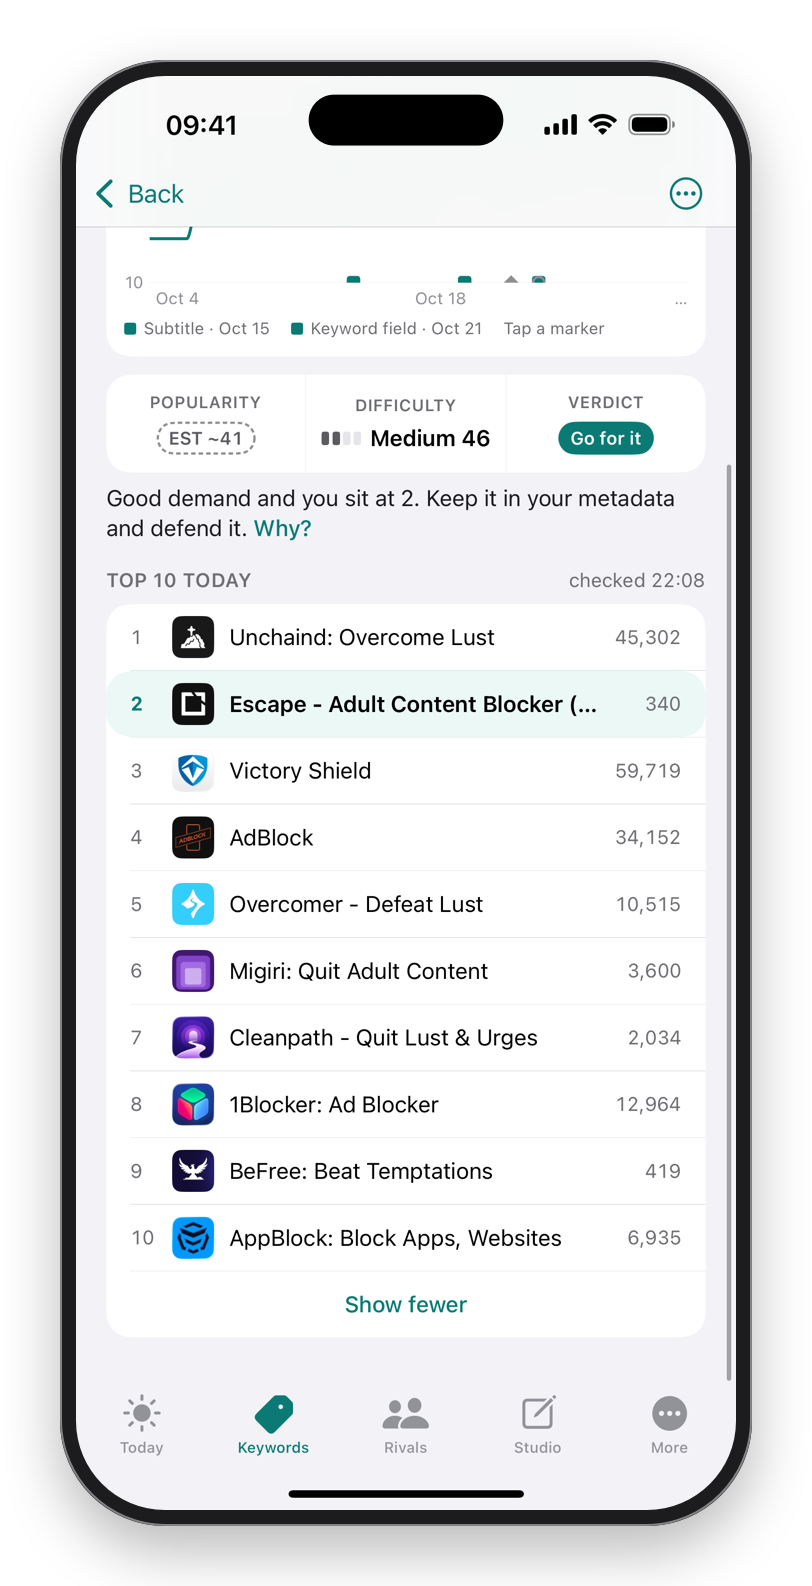
- 名称, 权重最高。名称里的词承载你占得最牢的词;对我们自己的应用 Escape,名称里的品类短语单独就占据第一,与副标题组合也是第一。
- 副标题, 权重其次。三十个字符,与名称组合。
- 关键词字段, 每个语言区域 100 个字符,按单个词读取,并与另外两处组合。
- 开发者名称, 权重很轻。
- 应用内购买的名称, 权重很轻,对有内购的应用而言。
- 应用所在的类别, 作为上下文,而不是作为词语。
在部分商店里,商店还会读取次级语言区域的字段:美国读 Spanish (Mexico),加拿大读 French (Canada)。哪个商店读什么。
哪些没有被索引
描述、宣传文本、更新说明、截图文案和评论。只出现在这些地方的词挣不到任何排名。描述依然重要,用于有人到达之后的转化,但只活在描述里的关键词不是关键词。
匹配是怎么运作的
词语跨三个字段组合匹配。分布在名称和字段里的 "adult"、"content" 和 "blocker" 能匹配 "adult content blocker"、"content blocker" 和 "adult blocker"。单数匹配复数。常见填充词被忽略。字段里词的顺序无关紧要;每个词是否存在才要紧。这就是为什么重复一个词、带空格写短语或添加复数都在浪费字符,也是为什么一个选得好的词能一次解锁好几个短语。
排名是怎么运作的
在匹配到的应用里,商店按它从词语匹配的精确程度和出现位置读出的相关性排序,再按它从应用历史里读出的表现信号排序:安装量,尤其是搜索这个词之后发生的安装,评分及其数量,以及活跃度。然后针对每个用户略作个性化。一个新页面起步时只有相关性这一半,这就是上线排名在头两周变动那么大的原因,因为表现那一半正在到来。七天断崖。
排名追踪器衡量的是什么
一个词在一个商店里个性化之前的中立结果,在固定的时刻读取:在匹配到的应用里,商店为一个没有历史的用户排出的你的位置。这就是你改页面、竞品改页面时会变化的那个数字。RankASO 每天为你追踪的每个词和每个商店读取它,读到第 200 位,并从同一份结果里读出每个竞品的位置。
这对你的页面意味着什么
把你最需要的两个短语放进名称和副标题。接下来的十四个词放进字段,每个一次,不重复,不填充。填好你主商店会读取的次级语言区域。然后去衡量,因为商店的权重不公开,知道你的词挣到了什么的唯一办法,就是追踪它们组成的词。
Download on theApp Store免费开始。无需账户。不收集数据。
常见问题
App Store 会为搜索索引描述吗?
不会。只有名称、副标题和关键词字段参与搜索索引,外加权重很轻的开发者名称和应用内购买名称。描述影响转化,不影响排名。
App Store 怎么匹配关键词?
把名称、副标题和关键词字段里的单个词以任意顺序组合,单数匹配复数,忽略填充词。一个词可以补全好几个短语。
为什么 App Store 排名在每个国家都不一样?
每个商店读取自己语言区域的字段,有自己的一批竞争应用和自己的安装量。同一个页面可以在一个国家排第一,在另一个国家毫无排名。